交流讨论💬
资产台账与全文检索
资产台账是 ECMDB 运维日常高频交互的业务核心。系统基于统一资产集合(c_resources)平铺存储,结合 Percona Server for MongoDB 原生 ngram 全文检索 技术,提供模糊匹配、多维组合筛选与跨多租户全局检索能力。
1. 资产台账与动态驱动
资产台账是各类型资源实例的统一视图,完全由模型元数据动态驱动:
- 统一平铺存储:全量资产实例统一写入
c_resources集合,标准字段(ID、名称、所属模型)与动态自定义属性(data映射)共存; - 动态自适应表头:根据当前模型配置的“资产展示列”按需投影字段,自适应渲染列表表头与增删改查表单;
- 敏感凭据自动脱敏:资产列表与检索响应自动识别加密敏感字段,在展示层执行掩码保护。
2. 原生通配 ngram 全文检索
运维排障时往往只掌握碎片线索(如 IP 片段 10.201、主机名缩写、序列号后几位)。传统 SQL LIKE '%keyword%' 会引发全表扫描,而通用中文分词器无法处理无语义分隔的 IP 或编码。
原理与技术优势
text
输入字符串: "192.168.1.100" (3-gram 连续滑窗切词)
切词倒排词根: ["192", "92.", "2.1", ".16", "168", "68.", "8.1", ".1.", "1.1", ".10", "100"]- 免外挂 ES 集群:依托 Percona Server for MongoDB 原生
ngram分词能力,无需额外搭建和维护 Elasticsearch 及同步组件; $**全字段自动捕获:通配捕获资产平铺的所有属性字段,无论是主机名、IP、SN 还是自定义扩展字段,写入即支持检索。
3. 两阶段检索与跨多租户大盘
为了兼顾海量资产的检索性能与企业多租户安全边界,ECMDB 创新性地设计了两阶段渐进式检索架构,并对普通租户与系统租户(超管) 提供了差异化的空间视图:
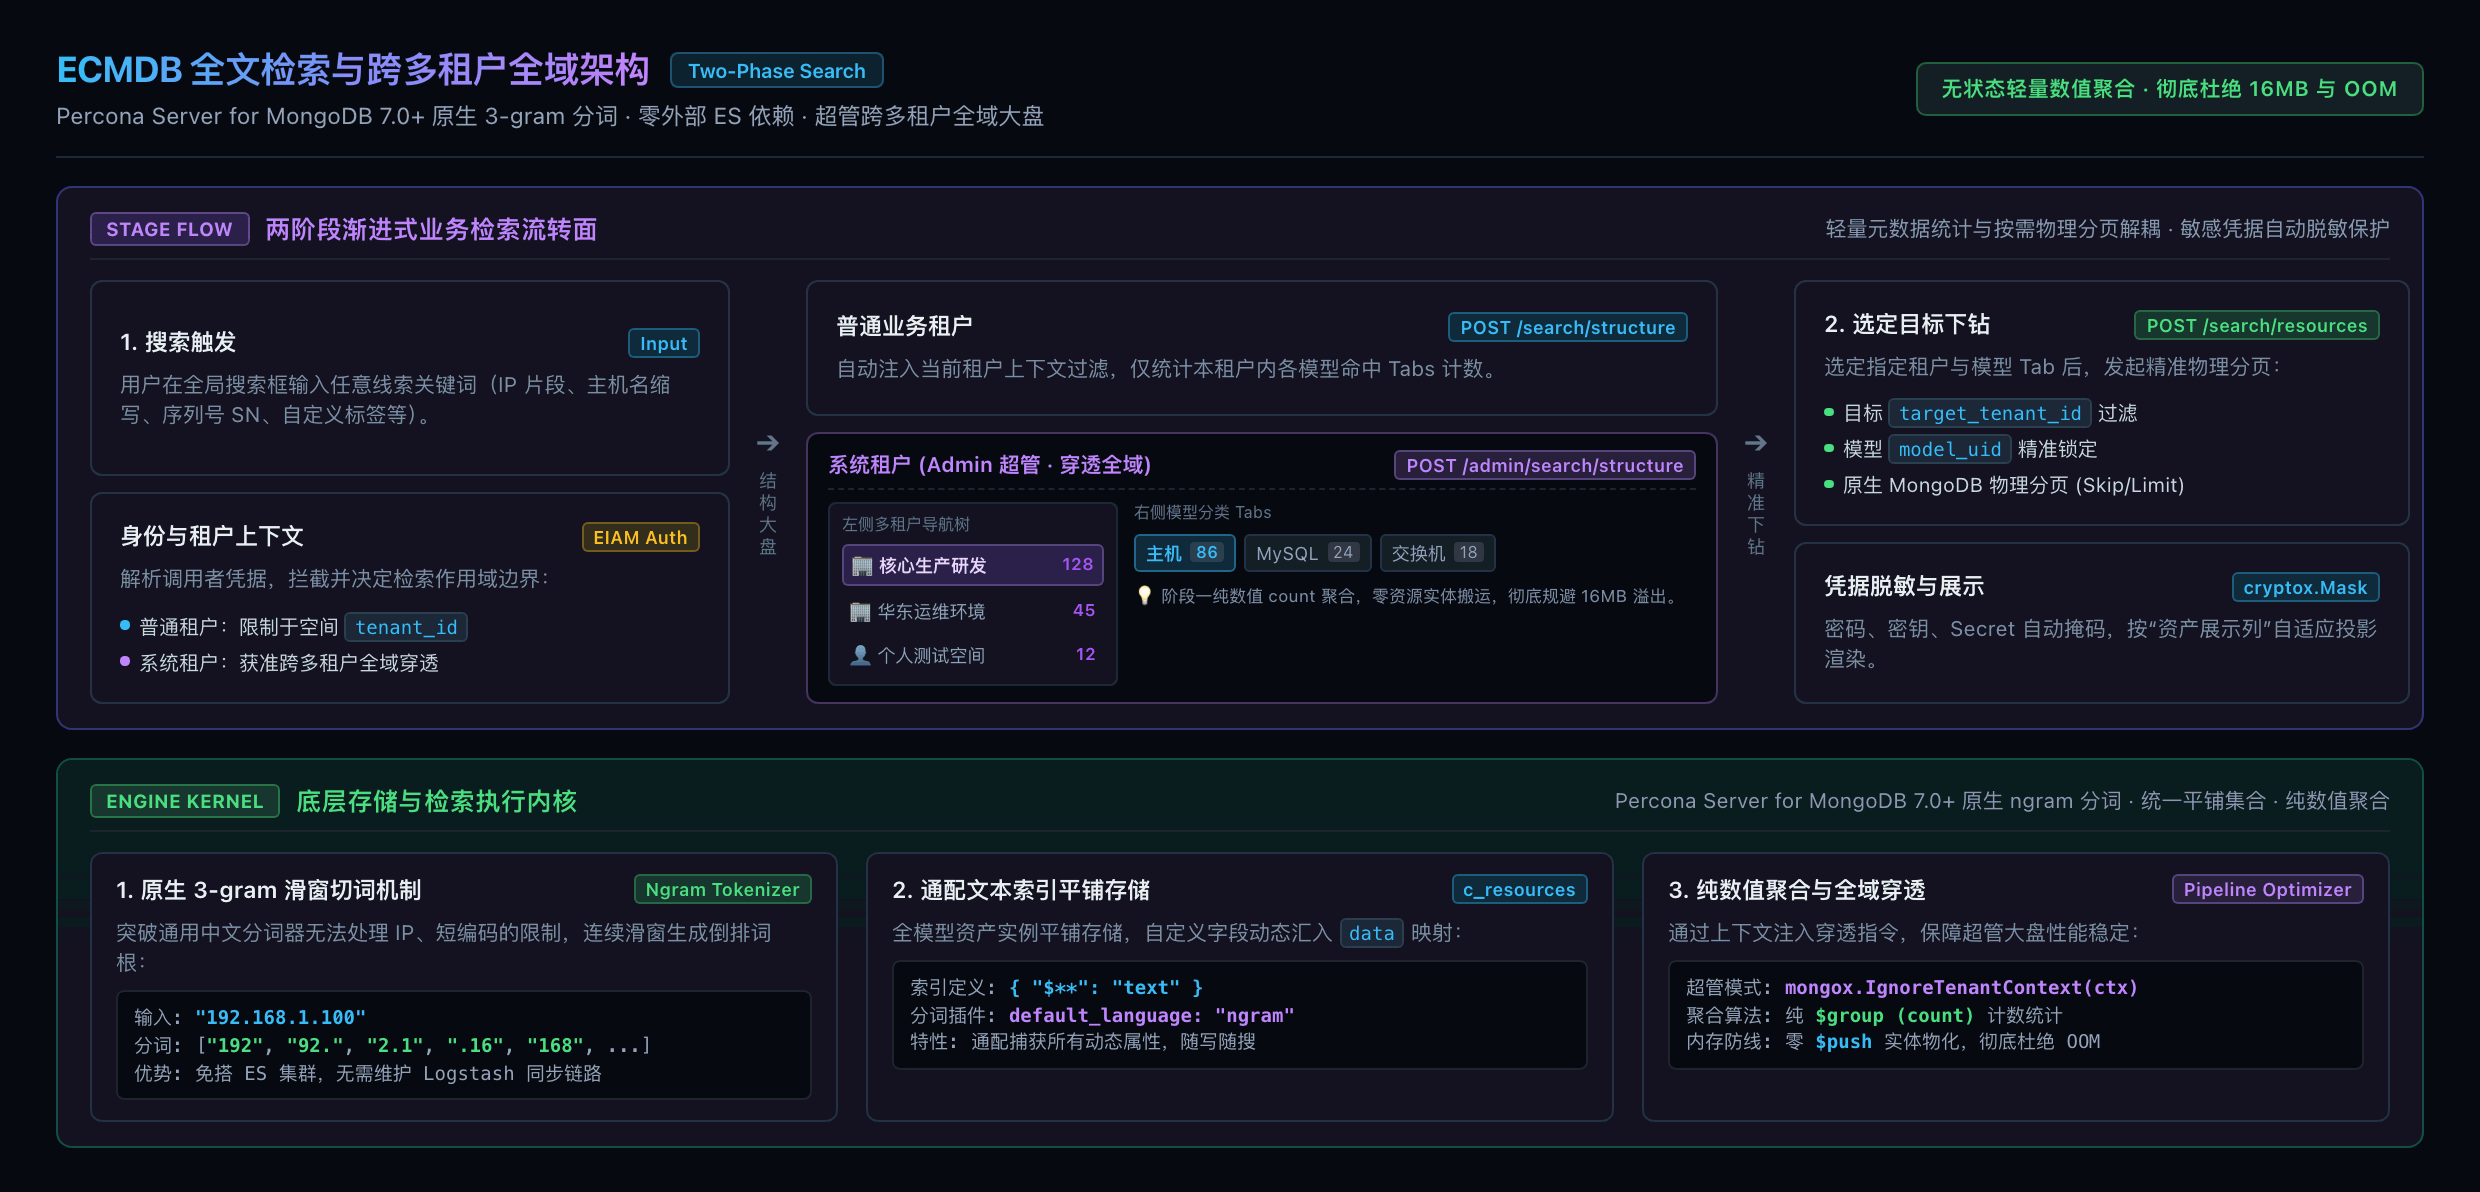
普通租户 vs 系统租户能力差异
| 检索维度 | 普通业务租户 | 系统租户 (Admin 超管) |
|---|---|---|
| 调用接口 | POST /search/structure | POST /admin/search/structure |
| 检索数据范围 | 严格单租户隔离 仅能检索属于自身 tenant_id 的模型资产 | 跨多租户全域穿透 穿透全量租户空间,覆盖系统内所有资产 |
| 阶段一:大盘结构 | 返回当前租户各模型的命中数量汇总 | 返回全域大盘:左侧多租户空间导航树(组织空间/个人空间)+ 右侧模型 Tabs 命中统计 |
| 阶段二:明细下钻 | 直接分页浏览当前租户命中的资产记录 | 自由选定左侧任意租户与右侧模型 Tab,下钻查看资产明细) |
| 底层机制 | 上下文自动携带 tenant_id 过滤 | 底层执行 mongox.IgnoreTenantContext 绕过多租户过滤,通过纯数值聚合杜绝内存溢出 |
为什么采用两阶段检索?
若在搜索时一次性跨所有模型和租户拉取明细,极易引发文档大小超限(16MB)或页面卡顿。ECMDB 采用阶段一纯数值轻量聚合命中分布,阶段二按需物理分页,首阶段仅统计命中计数,按需下钻后再查询具体资产明细。
4. 高级组合筛选与数据导入导出
组合条件过滤
除全局模糊搜索外,资产台账支持精准多维复合查询:
- 等值精确过滤:如厂商
cloud_provider == "Aliyun"且机房region == "cn-hangzhou"; - 数值与时间范围:如 CPU 核数
cpu_cores >= 16,创建时间在近 7 天内; - 多选标签筛选:对资产打上的业务标签进行交集/并集筛选。
批量数据导入导出
- 动态 Schema 模板生成:系统根据目标模型的最新字段定义,自动生成带有格式校验规则与枚举下拉的标准 Excel 模板;
- 严格入库预检:导入时在内存中批量执行必填校验、唯一性约束检查,错误精准定位到 Excel 具体行数;
- 批量事务处理:大批量导入采用分页事务入库,单次支持数万条资产平滑写入。